 AI Plan
 AI Build
 AI Run
 AI Change
SolutionDiagnostic Data & IA
Évaluez votre maturité et construisez une roadmap priorisée.
Découvrir le diagnosticOffres
De l’opportunité au passage à l’échelle.Évaluez votre maturité et construisez une roadmap priorisée.
Découvrir le diagnosticComment une couche sémantique aide les agents IA à interroger les données métier avec des définitions communes, et quand elle devient pertinente.
 Faustin LaînéCMO
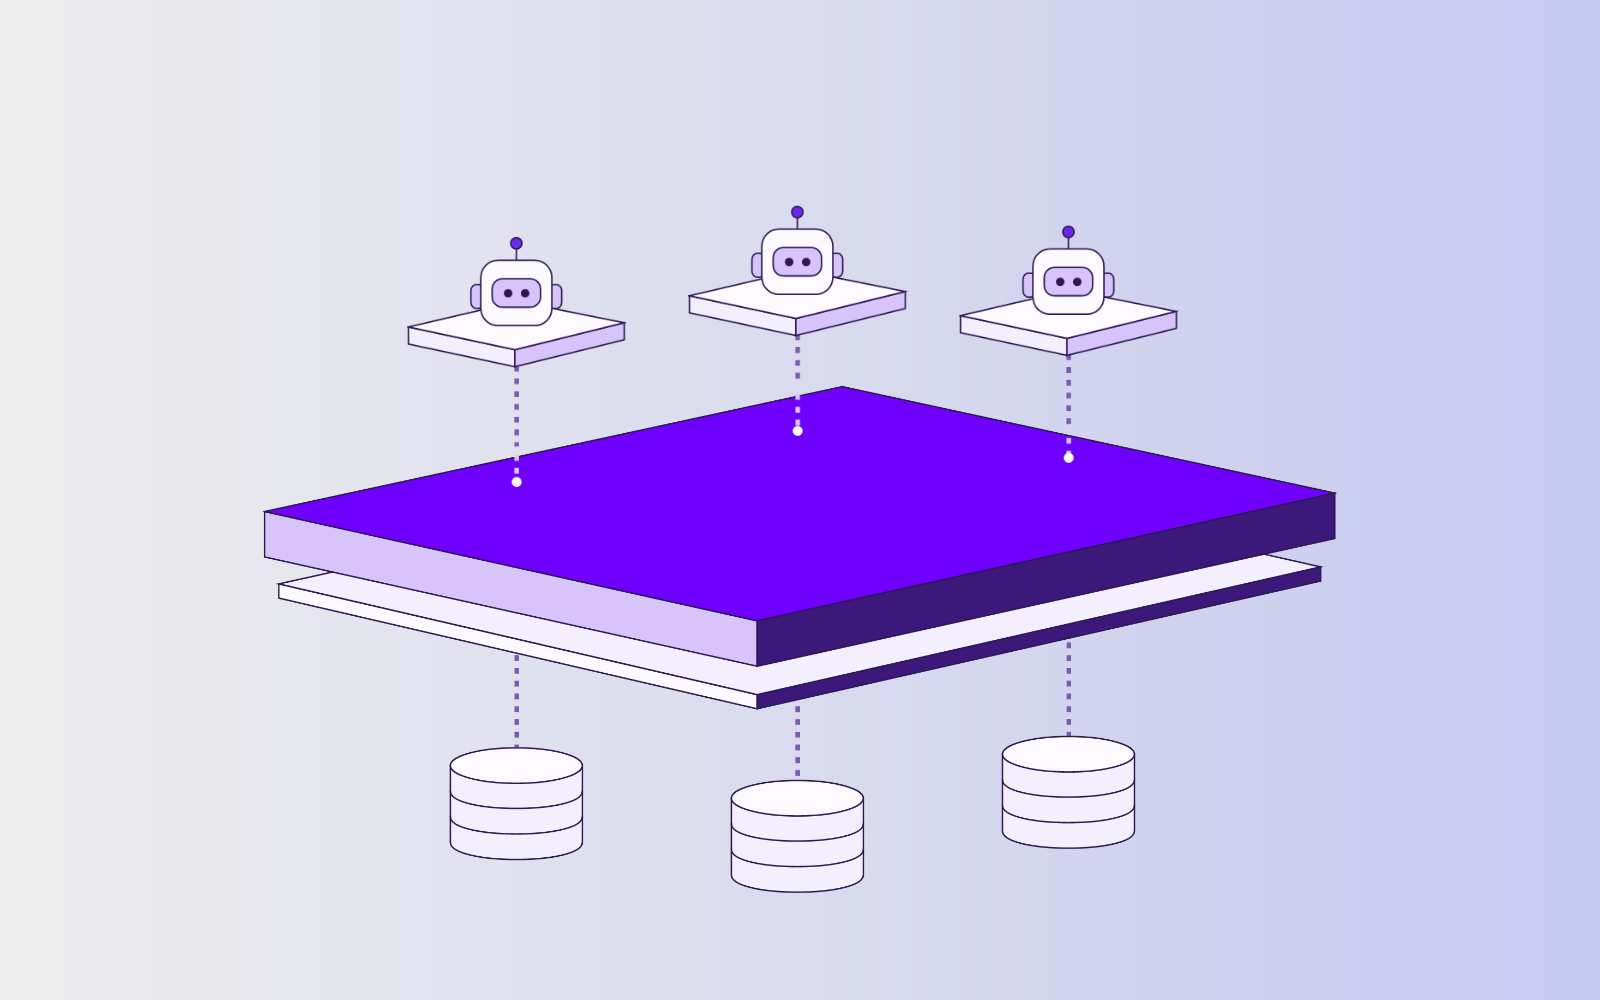
Une couche sémantique donne aux applications une définition commune des données qu’elles utilisent. En business intelligence (BI), elle peut fixer le calcul du chiffre d’affaires net, la date à retenir et les transactions à inclure. Un tableau de bord et un agent IA peuvent alors calculer le chiffre à partir de la même définition, même si l’un affiche un graphique et l’autre répond à une question en langage naturel.
Cette convention compte dès qu’un agent doit répondre à une question comme « Quel chiffre d’affaires avons-nous réalisé le mois dernier ? » Si l’entreprise suit les ventes à la date de facturation et que l’agent retient la date de commande, la requête peut s’exécuter sans erreur et produire un chiffre différent de l’indicateur officiel. Une requête prédéfinie peut résoudre ce problème pour le premier agent. L’intérêt d’une couche sémantique grandit lorsque le même calcul doit servir à plusieurs applications et évoluer avec elles.
La couche sémantique, ou semantic layer, relie des concepts métier à la structure technique des données. Elle peut définir des entités comme un client, une commande ou un produit, leurs attributs et les relations qui permettent de les interroger ensemble. Elle peut aussi préciser le niveau auquel s’applique une information. Dans un catalogue, une caractéristique peut valoir pour toute une gamme tandis qu’une finition n’est disponible que sur certaines références. Cette distinction détermine les résultats d’une recherche produit.
Une vue SQL peut porter une partie de cette logique en rassemblant les champs nécessaires à une recherche. La différence tient à la manière dont cette logique est mise à disposition. Une vue conçue pour un service peut, par exemple, présenter une ligne par référence et réunir les attributs utiles à son interface. Une couche sémantique peut exposer séparément les concepts de gamme, de référence et de finition, définir leurs relations et permettre à plusieurs services de les interroger à des niveaux différents. Des vues SQL peuvent servir de base à cette représentation commune.
Une API décrit les opérations disponibles et le format de leurs réponses. Un schéma SQL indique comment les données sont stockées. Dans les deux cas, l’agent peut disposer de plusieurs champs qui paraissent convenir à la question. Pour chercher des références commercialisables, par exemple, il doit savoir quels statuts recouvrent cette notion. Pour calculer un montant, il doit aussi savoir à quel niveau compter chaque valeur. Une jointure entre les commandes et leurs lignes peut répéter le montant d’une commande autant de fois qu’elle contient d’articles.
Pour un agent chargé d’une opération précise, on peut réduire cette ambiguïté en exposant un outil qui accepte uniquement les paramètres attendus. Le modèle interprète la demande et renseigne les paramètres disponibles. Si la période ou le sens d’un terme reste ambigu, l’agent peut demander une précision. L’application valide ensuite les paramètres et exécute une requête prévue pour cet usage. Cette approche permet de vérifier séparément la qualité de l’interprétation et le résultat du calcul.
Un changement dans la définition du chiffre d’affaires net donne une idée du travail à prévoir. Si le métier décide de traiter certains avoirs différemment, l’équipe doit retrouver les tableaux de bord, agents et services qui calculent cet indicateur, puis vérifier que la nouvelle règle est appliquée partout. Quand ces applications interrogent déjà une définition commune, la mise à jour se fait à un endroit identifié. Il reste à valider le nouveau calcul, à vérifier ses effets pour les consommateurs et à décider quand il entre en vigueur.
Partager les définitions suppose aussi de rendre visibles les différences légitimes. Un assistant commercial peut appeler « client actif » un client dont le contrat est en cours, tandis qu’un rapport de ventes retient les clients qui ont acheté dans les douze derniers mois. Deux concepts nommés explicitement permettent de conserver ces usages et d’expliquer les écarts entre leurs résultats. Le passage des tableaux de bord officiels aux interfaces conversationnelles en BI (nouvelle fenêtre) rend cette responsabilité plus visible, car une question en langage naturel peut désigner l’un ou l’autre calcul.
Pour répondre à une demande de chiffre d’affaires net par région, le modèle identifie la métrique et extrait les paramètres, dont la période et le niveau de détail. L’outil valide ces paramètres avant d’interroger la couche sémantique. Celle-ci applique la formule et les relations entre les données. Le service ou la plateforme de données applique les droits associés à l’identité d’exécution. Les traces peuvent ensuite indiquer la métrique, les filtres et la version de la définition utilisés pour produire la réponse.
Avec dbt Semantic Layer (nouvelle fenêtre), par exemple, un tableau de bord et le service appelé par l’agent peuvent interroger la même métrique à partir des modèles de données. L’agent fournit la période et le découpage demandés. Le moteur de requêtes utilise la formule et les relations définies dans dbt. Si la règle de calcul évolue, le service n’a donc pas à la réécrire dans les instructions du modèle.
Cette répartition laisse à chaque composant une responsabilité précise. Le pipeline ETL prépare et charge les données, puis le modèle de données organise leur structure. La couche sémantique expose le sens métier, tandis qu’un moteur de règles peut s’en servir pour filtrer des références compatibles ou classer des résultats. Une architecture RAG en production (nouvelle fenêtre) peut compléter ce dispositif en retrouvant le passage d’une notice qui explique une contrainte de pose. Si cette contrainte doit s’appliquer à chaque recherche, elle peut être codifiée dans l’outil de recherche pour filtrer les produits avant de les retourner.
Pour prolonger en ligne le conseil donné en showroom, aiko a conçu le conseiller IA de Heytens (nouvelle fenêtre), capable de traduire le besoin d’un client en critères de recherche pour des rideaux, voilages ou stores sur mesure. Dans le PIM Quable, le catalogue était encore en cours d’enrichissement, les informations se répartissaient entre gammes et produits finis, et le type de produit devait être déduit de la classification. Pour réunir les attributs utiles à la recherche, aiko s’appuie sur les fichiers CSV exportés par l’équipe IT et reconstruit une base PostgreSQL avec des vues adaptées aux requêtes du conseiller.
Lorsqu’un client veut laisser passer la lumière tout en se protégeant du vis-à-vis, une étape d’extraction par LLM, distincte de l’agent conversationnel, utilise un schéma aligné sur le catalogue. Le champ « opacité » accepte les valeurs « occultant », « tamisant » et « transparent ». La description du champ guide ici le modèle vers « tamisant ». Le backend applique cette valeur comme filtre strict dans la requête initiale, puis utilise les règles de recommandation. Les caractéristiques présentées au client proviennent de la base.
Quentin Lavallée, AI Engineer chez aiko, décrit ce dispositif comme un modèle orienté recherche produit. Les définitions et les règles sont réparties entre le schéma d’extraction, les vues SQL, les requêtes et le code de l’agent. La base a facilité l’ajout de la visualisation, avec des vues adaptées à cet usage.
Chez Heytens, l’équipe IT et aiko ont discuté de la possibilité de mutualiser le pipeline et la base produit. Si cette piste se concrétise, une couche sémantique pourrait rendre la relation entre gammes, références et finitions interrogeable aussi bien par le conseiller que par le service de visualisation. Chacun pourrait continuer à présenter les produits selon son usage, à partir d’une définition commune de leurs relations.
Pour un agent qui exécute quelques requêtes stables, une vue SQL documentée et un outil aux paramètres bien définis peuvent suffire durablement. La mise en place d’une couche sémantique devient plus pertinente lorsque plusieurs services reconstruisent les mêmes relations, lorsqu’une règle métier doit être modifiée à plusieurs endroits ou lorsque l’entreprise doit retracer précisément le calcul d’un résultat. Le coût de maintenance dépend alors du nombre de définitions à partager, de leur stabilité et de la capacité du métier à les arbitrer.
Pour décider, on peut partir d’un concept déjà utilisé par deux services. Leurs équipes comparent leurs définitions, testent les cas limites et font valider une convention commune par le métier. Une évolution réelle de cette convention permet ensuite de vérifier si les deux services peuvent l’appliquer sans réimplémenter la règle. Ce test donne un périmètre concret à la première version de la couche sémantique.